Почему этот ещё недавно казавшийся очень странным вопрос вообще возникает? Всему виной, конечно же, ИИ.
Ниже мой braindump лонгрид на тему.
Подходы к работе с ИИ
В программировании прямо сейчас существует, наверное, порядка четырёх подходов к работе с ИИ-агентами.
Промпт-инжиниринг
Промпт-инжиниринг, или промптинг, — это, по сути, работа в режиме «вопрос — ответ». Наверное, можно сказать, что это начальный уровень взаимодействия с ИИ: ты формулируешь правильные вопросы и задаёшь их, в ответ получаешь ответы, возможно, даже кусочки кода или цельные функции. Эта фаза всегда присутствовала в работе и раньше, только инженер шёл с вопросом в Google или StackOverflow, а чуть раньше — на тематические форумы вроде JavaRanch.
Если говорить про командную работу, то с вопросом можно было подойти к опытному и знающему коллеге: связь ментор — менти или джуниор — сеньор.
Сейчас вот эту фазу может заменить и уже заменяет общение с ИИ-чатом: он в одном лице и агрегатор тематических баз знаний, и поиск, и старший опытный товарищ, готовый всегда помочь.
Ключевая особенность этого подхода в том, что ИИ-агент не имеет доступа к проекту и кодовой базе, не видит весь контекст — это просто «поиск на стероидах», который отвечает на очень конкретные вопросы, и весь контекст — это то, что есть в чате. В общем-то, это просто чат.
На этом уровне я начал работать где-то в начале 2024 года. Для диверсификации инструментария я использовал и использую DeepSeek для быстрых вопросов типа поиска, более основательные данные и ответы я получаю от ChatGPT или своей банды Grok-ботов — я их называю миньонами.
Агентная инженерия
Агентная инженерия — это режим, когда вы пустили ИИ в том или ином виде в ваш проект и код, и он владеет доступом ко всему необходимому, чтобы наравне с любым членом команды выполнять задания, и может сам собрать весь необходимый контекст. То есть это уже программирование через агентов в IDE Cursor или ZCode, использование инструментов и моделей Claude или Codex с доступом к кодовой базе.
Вы ставите задачу агенту, тем самым запуская его сессию. В рамках сессии общаетесь, уточняете детали, корректируете принятые решения, ревьюите код. ИИ-агент тут исполнитель, но не самостоятельный: он ждёт от вас ответов на вопросы, может бросить работу на полпути и остановиться, может с первого запроса сделать не всё так, как надо. Это такой ваш подчинённый, за которым надо следить, наставлять и направлять. Но он способен полноценно выполнять задачи end-to-end, где вы уже не занимаетесь написанием кода или его проектированием на низком уровне — вы скорее тимлид и техлид.
Ключевой момент этого подхода в том, что ИИ-агент уже полноценный работник: он создаёт полноценные фичи и решает цельные задачи, а не отвечает обрывками кода на вопросы в чате. Но он всё ещё не очень самостоятельный, и вы не можете, поставив ему задачу, надолго отлучиться от компьютера. Вы всё ещё тот человек, который принимает больше решений, чем сам ИИ.
Где-то с 2025 года я начал активно использовать этот подход с Cursor, почти сразу пересев на Glow-интерфейс, где сфокусировался на планировании, а не на кодировании, предоставив весь нужный контекст агенту и в кодовой базе, и вне её — через MCP-протокол к трекеру, дизайнам в Figma и всему остальному, — аккуратно обложив агента ignore-файлами, md-файлами правил работы, настройкой песочницы и ключами в KeyChain.
Агентный цикл
Агентный цикл. Настоящая автоматизация и автономия начинаются, когда работа ИИ-агента строится по принципу цикла, итеративной работы, где последовательно идут этапы планирования, реализации, тестирования и ревью без участия человека. При помощи скилла или команды триггерится главный агент-наблюдатель, который запускает субагентов для реализации — одного или нескольких параллельно для декомпозированной задачи.
Прагматичный подход — ограничить циклы: задать конечное число итераций кросс-модельного или субагентного ревью, вносить только правки по критичным замечаниям и по тем, где у моделей есть консенсус. При помощи awake-механизма основной агент-исполнитель запускает агентов-ассистентов и так крутится в цикле без участия человека, пока задача не будет выполнена.
Такую работу машина выполняет сама: вы можете запустить цикл на ночь и отлучиться от компьютера без боязни, что агентная сессия оборвётся или застрянет в ожидании вашего ответа.
Цикл реализации задачи можно построить строго до создания запроса на изменение кода, а можно — вплоть до ревью изменения и слияния его в основную ветку после прохождения всех проверок CI/CD, полностью без участия человека.
Схема агентного цикла из документации Claude Code: промпт → оценка модели ⇄ вызовы инструментов → финальный ответ.
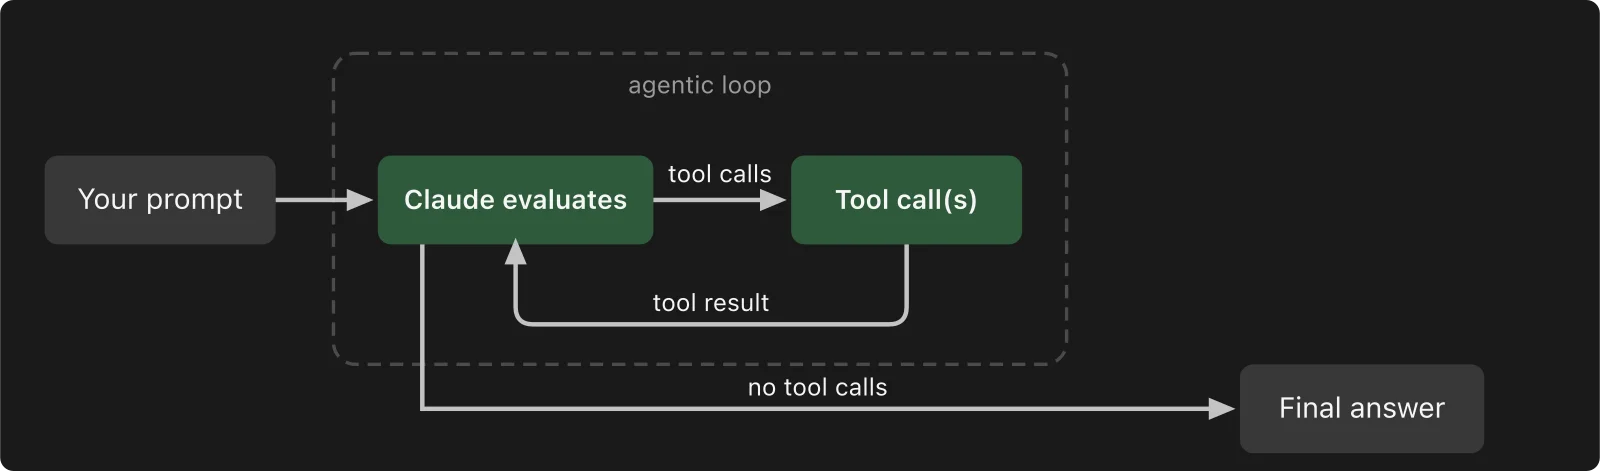
В 2026 году я начал чувствовать себя уверенно, чтобы запускать циклы с мультимодельным ревью в Cursor, а позже перестал гнаться за моделями, пересел на ZCode из-за неудобства переключения нескольких VPN и организовал субагентные итерации ревью и реализации одной и той же модели GLM.
На самом деле, по ощущениям, я не потерял в качестве: современные версии моделей почти любого провайдера хорошо справляются со средней задачей кодирования. А на моём опыте стравливание разных моделей через
/multi-model-reviewдаёт очень большой рассинхрон по решениям, где количество споров и галлюцинаций без консенсуса только возрастает. Я стравливал GPT, Claude, GLM, Muse, Kimi и Composer — обычно минимум три разные модели.
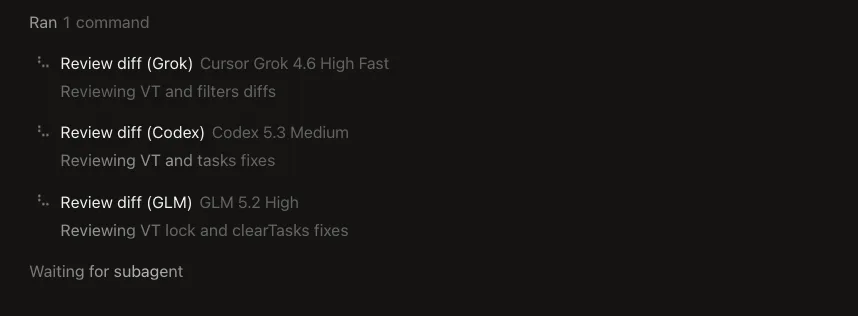
Субагентное ревью через
subagent_type: general-purposeодной моделью даёт более целостный результат без упоротого перфекционизма.
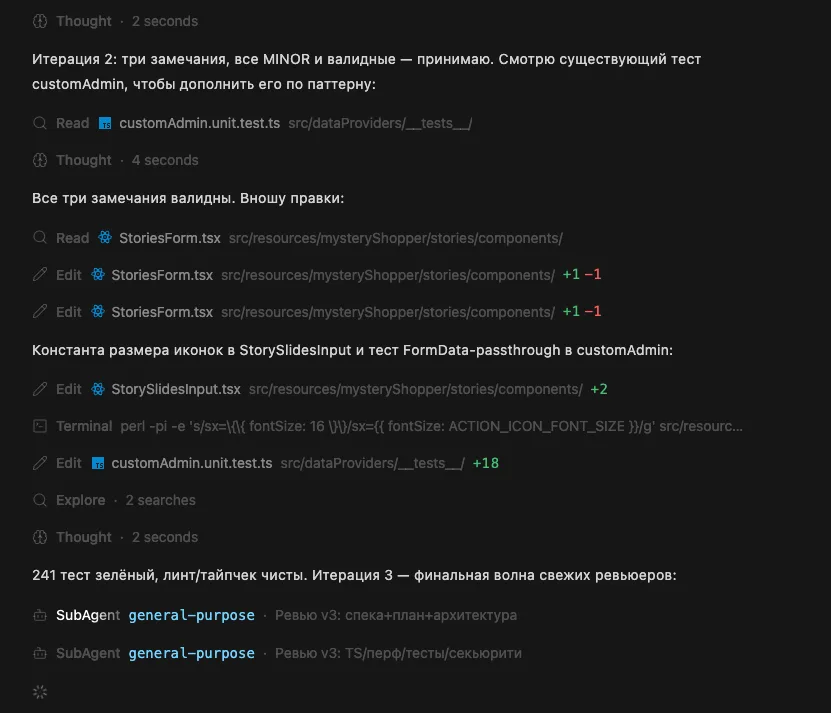
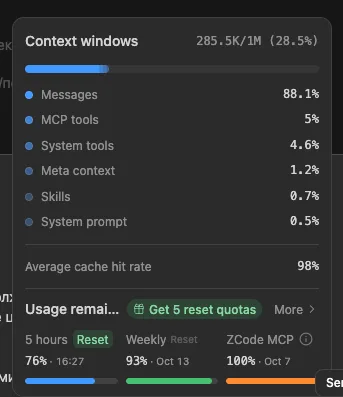
Каждый цикл, запущенный на одну специфичную задачу, если в него не вмешивается человек, получается крайне эффективным с точки зрения токенов. Контекст не меняется, а аккумулируется, в работе нет долгих перерывов, что позволяет использовать кэш. По моему опыту почти все циклы имеют коэффициент попаданий в кэш свыше 90%.
Агентная фабрика
Агентная фабрика. Агентный цикл реализует одну задачу, а задач за день бывает несколько. Тут всё ещё есть ручной момент постановки задачи и запуска цикла: человек решает, сколько циклов запустить и сколько задач решать параллельно. Агентная фабрика — это цикл более высокого порядка с агентом-оркестратором над агентными циклами реализации.
Хорошая аналогия — бесконечный игровой цикл или Event Loop в JavaScript, который постоянно крутится как daemon, ожидая задач: мониторит вашу доску в системе трекинга или директорию с md-файлами описания задач.
Как только задача появляется на доске или в директории, агент-оркестратор берёт её в работу и запускает для неё цикл реализации из подхода 3.
В зависимости от мощности машины, ресурсов и настроек он принимает решение, сколько задач взять в работу параллельно, и настраивает изолированные working tree и окружения для каждой, чтобы циклы реализации не мешали друг другу. В общем, это фактически копия того, как раньше работали человеческие команды, только теперь в этой схеме технический специалист уже не нужен — нужен только тот, кто ставит продуктовую или бизнес-задачу. Всё остальное делают агенты.
Это подход, в который я пока сознательно не иду: с одной стороны, потому что он не особо нужен в соло-разработке, с другой — потому что не уверен, что готов отпустить руль и вовсю нажать на газ. Даже в третьем подходе я не разрешаю агенту создавать запрос на слияние и сливать его в основную ветку. Пока я где-то именно в этой точке и пытаюсь соблюдать баланс. Ниже как раз размышления, почему я до сих пор не отпускаю руль.
Я сознательно не упоминаю вариант не использовать ИИ вообще — пускай он будет нулевым, как первый индекс в массиве. Этот подход уже архаика: если инженер не использует ИИ вообще никак сегодня, то он очень сильно отстаёт от индустрии.
Вопрос, писать код самому или нет, вообще не стоит — он уже решён. Человек, даже самый талантливый, умный и дисциплинированный в этом ремесле, не сможет напечатать столько кода, сколько может генерировать ИИ-агент даже на самой простой LLM-модели. Недавняя история разработчика официального клиента Telegram для macOS говорит сама за себя: 99,9% клиентского кода там теперь пишут ИИ-агенты, а 80–90% инженеров компании, по его оценке, уже не пишут код руками. Когда такое заявляла команда Antropic или OpenAI, к этому нельзя было серьёзно относиться, потому что они продают свои инструменты и, само собой, будут делать это как минимум в качестве пиара. Но команда прикладных инженеров топового продукта в мире — это уже другое.
Вопрос: надо ли читать код, сгенерированный ИИ? Подходы один и два ещё позволяют как-то всё держать под контролем и читать код глазами, но они и не сильно автоматизируют работу — в том плане, что это пока не революция. Первый подход — просто замена привычных инструментов поиска и исследования проблемы. Второй — аутсорс набора текста, но в этой схеме поставить задачу, потом самому её проверять, а в случае неточностей исправлять или просить исправить суммарно может занять столько же времени, сколько вы сами запрограммировали бы решение, а в отдельных случаях — даже больше.
Третий и особенно четвёртый подходы — это то, где происходит настоящая магия, и ты задумываешься: а нужен ли ты теперь вообще в этом цикле разработки? Если человек всё ещё в этом цикле, и мы ждём, пока он что-то просмотрит глазами, прочитает, разберётся, поймёт суть и смысл, то мы, конечно же, тормозим процесс, а сама автоматизация уже не является такой автономной.
Цикл за ночь создал 20 запросов на слияние кода, а вам с утра это разгребать. Если не успеете — в течение дня и следующей ночи к этому числу прибавится ещё несколько десятков. А если каждый участник команды накинет по 20 PR-ов?
Идея оставить человека внутри цикла сейчас — предмет споров. Читать или не читать код, который сгенерировал ИИ? Даже внутри конвейера поставки: должен ли человек делать ревью каждого запроса на изменение, или ИИ-агент сам доводит изменения до целевой ветки?
Код больше читать не нужно, или «Лови гранату»
В эпоху ИИ неотвратимо то, что часть кода будет проходить мимо человеческих глаз просто из-за скорости генерирования и своего объёма.
Дело в том, что даже начиная со второго подхода количество кода, которое генерирует человек, использующий агента, возрастает кратно. Если всё это будет ожидать в очереди полного прочтения и верификации человеком, то процесс ревью, как и ручного тестирования, станет чудовищным по своему маленькому диаметру бутылочным горлышком.
Тонны кода будут висеть в ожидании слияния и тестирования, успешно протухая. Согласно отчётам этого года, показатель code churn — кода, который переписывают или удаляют вскоре после слияния, — вырос на 861%, а медианное время ревью — на 441%. Агентские PR в среднем на 51% больше обычных, около 28% из них мержится почти мгновенно, а число PR, уходящих в основную ветку вообще без ревью, выросло почти на треть.
Интересен и другой феномен: сейчас появился термин шлак-граната (slop grenade) — так его использует CEO Shopify. ИИ-агент генерирует много кода, а сотрудники настолько полагаются на ИИ, что перекладывают реальную работу — чтение, проверку и осмысление результата — на следующего человека в цепочке: техлида, ревьюера, ручных тестировщиков. Я сам лично наблюдал этот феномен в X5, когда человек выкатывал PR на пять тысяч строк кода, вообще не прочитав то, что там было. А там был код далеко не самого лучшего качества.
Когда ревьюер получает такие «шлаковые гранаты», ему ничего не остаётся, как вернуть на доработку и потратить кучу времени на то, чтобы тыкать пальцем, где надо отредактировать. Это удлиняет процесс поставки, а не укорачивает его. ИИ-автоматизация не работает, а наоборот — оборачивается против тех, кто её внедряет.
Собственно, поэтому парадигма и сдвигается к подходам 3 и 4, где циклы крутятся, всё меньше задействуя человека, а ставка в проверке и качестве выдаваемого кода делается на сами LLM и ИИ-агентов.
На передний план выходит критичность верно выстроенного harness и quality gates, чтобы крутить такие циклы.
Дядя Боб — автор, за которым многие инженеры уже много лет следят и руководствуются его советами, — накидывает на вентилятор: он перестал читать код, а сосредоточен на инструментах и проверках, которые заставляют его агентов производить чистый код и следовать принципам.
Борис Черни, глава Claude Code в Anthropic, заявил, что 100% его кода генерит Claude.
Современные пионеры разработки ПО и старожилы сходятся во мнении: код можно не читать.
Снятие ограничений, или «С Ruby на Rust»
Другой интересный момент с чтением кода — это расширение своих компетенций, а точнее — снятие с себя ограничений.
DHH на Rails World 2026 с пеной у рта практически кричал со сцены, что код ни писать, ни читать теперь не надо: можно взять самый оптимальный компилируемый язык вроде Rust, написать на нём сервер, а все клиенты заменить на нативные реализации под конкретную ОС — и при этом не иметь навыков программирования, чтения и понимания кода на Rust, попутно обозвав этот язык самым неудобным и нечеловечным для чтения.
Свои тезисы он подкрепил цифрами производительности, которые впечатляют, — если бы речь не шла о концептуальной подмене технологий: сравнивать веб-технологии и компилируемое системное ПО в производительности некорректно.
Доклад ужасен, я написал своё мнение про это отдельно.
Но тем не менее DHH прав в том, что, не печатая код, не читая код и не разбираясь в нём, можно достичь очень впечатляющих результатов — и это повод для дискуссии.
Если убрать аспект чтения и понимания кода, вынести за скобки тот факт, что для глубокого владения хотя бы одним языком программирования нужны годы практики и опыта, то открываются очень интересные возможности.
До недавнего времени люди делились на очень конкретные компетенции, специализировались в определённых областях, и их количество только росло: серверная разработка на стеке Java, серверная разработка на стеке Go, машинное обучение с Python, фронтенд с JavaScript, мобильная разработка под iOS со Swift. Может ли один разработчик уместить в себе все эти знания? Fullstack? Два-три языка? Тот, кто вам такое продаст, — шарлатан!
Я достаточно давно занимаюсь веб-платформой и JS, но не уверен, что могу заявить, что знаю о нём всё. Это ведь очень живой процесс.
Так вот, ИИ как будто убирает эти барьеры и открывает ящик Пандоры. Появляется соблазн не ограничивать себя. Нужно написать прошивку под микроконтроллер? С ИИ я могу сделать реализацию на Rust. Подключить микросервис на Go? Не проблема, с ИИ я могу и это. Построить SPA на Vue.js или Svelte? Легко. Как вы понимаете, ни с одним из этих инструментов до этого я не выходил в прод и не очень ориентируюсь в лучших практиках написания кода.
Джаред Самнер переписал Bun с Zig на Rust, и это выглядит как подтверждение того, что код можно и не читать. Теперь это просто ещё одна абстракция.
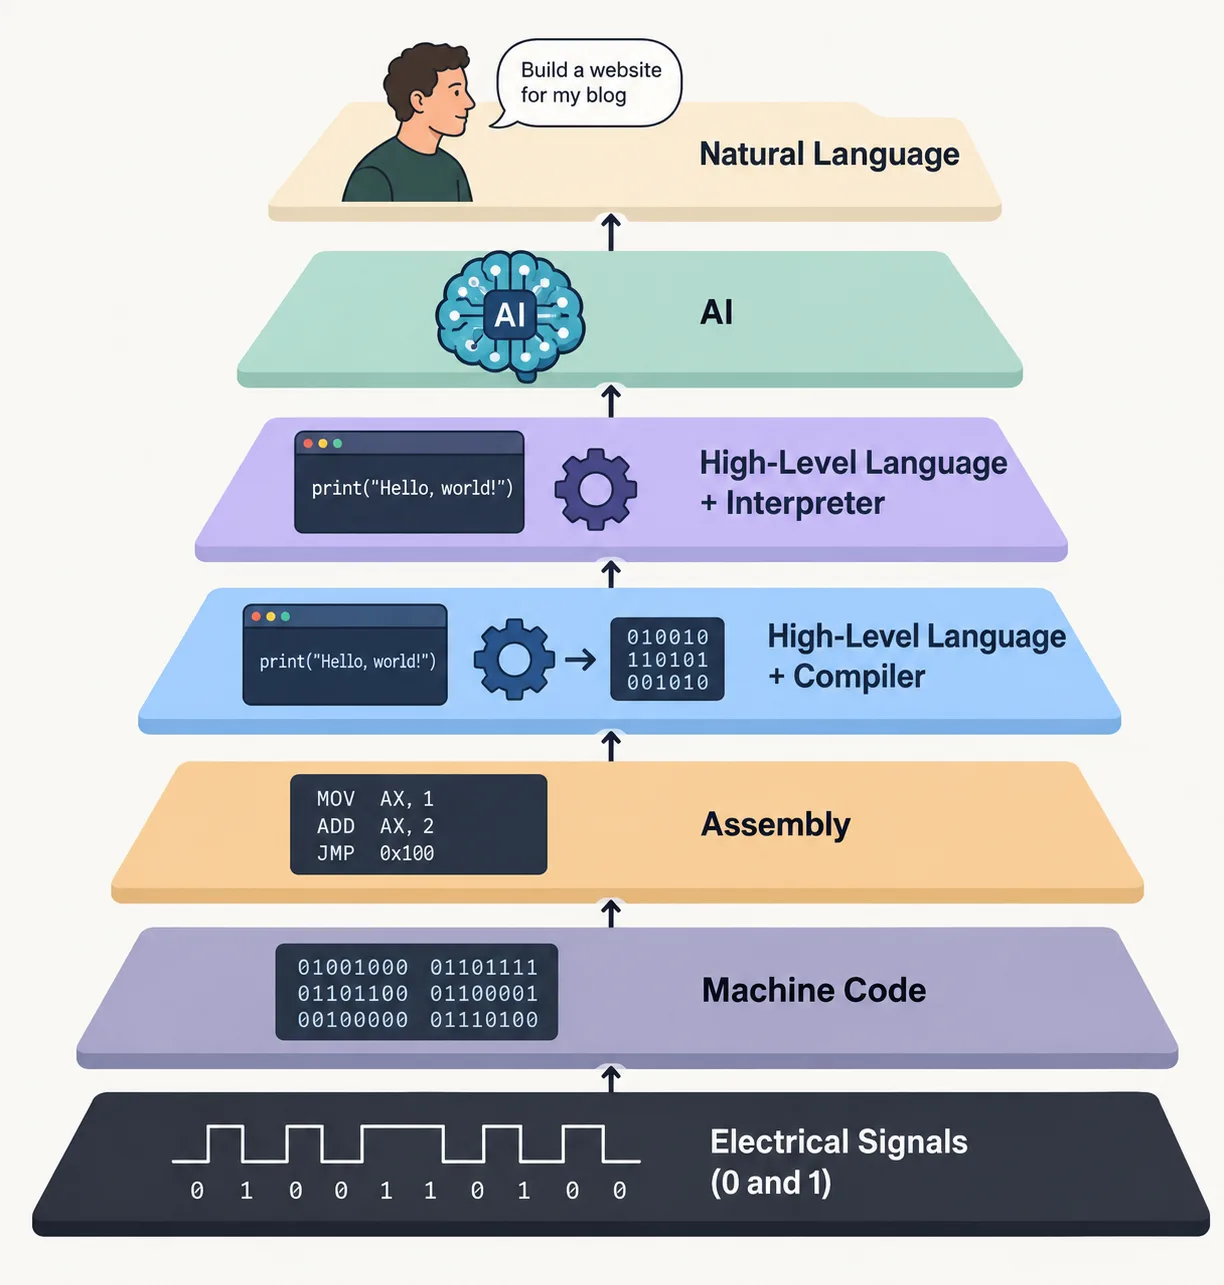
Адепты этой идеи апеллируют к тому, что мы же не читаем ассемблер или машинный код. Зачем нам читать код на Rust? Нам надо сосредоточиться на естественном языке, а не формальном, и больше уделять времени концепциям, планированию и тому, что мы хотим получить в конце, а не тому, как мы хотим это реализовать.
Развитие языков программирования
Давайте попробуем сделать интеллектуальное упражнение. Предположим, что в перспективе десяти лет все перестали читать код формальных языков. Как будут развиваться языки?
Скорее всего, эволюция языка должна идти к синтаксическому упрощению для машин, чтобы объём информации было легко и быстро обработать. Такой вектор, скорее всего, сопряжён с тем, что языки отдаляются от DSL и становятся ближе к чему-то невидимому для человека, но простому для машин.
Сейчас, что бы ни сгенерировал ИИ, можно найти специалиста, который это прочитает, разберётся и поймёт логику, потому что код пишется на основе синтаксиса, с которым человек работал годами.
Если не читать новые кодовые базы, а сам язык эволюционирует для машин и деградирует для людей, то во временной перспективе мы не сможем найти инженера, который сможет его прочитать и разобраться.
Джеймс Дума, известный независимый аналитик нейросетей Tesla FSD, написал, что он, возможно, «больше никогда не посмотрит на исходный код» — как когда-то перестал смотреть на ассемблер, потому что доверил компилятору делать это правильно. В ответе Илона Маска сказано, что это в точности верно и что следующим шагом будет полный отказ от исходного кода и прямая генерация эффективного двоичного кода с помощью ИИ. Фантастика?
На самом деле предсказывать, что будет с тем или иным языком программирования, очень и очень сложно.
Java создавался как модная замена C/C++, и в 90-е был поводом заманить талантливых инженеров к себе в компанию. В итоге этот язык стал топовым выбором для разработки веб-серверов, а не нативных ОС-приложений.
JavaScript создавался на коленке Бренданом Эйхом как скриптовый язык с лёгким порогом входа для не-инженеров — дизайнеров, веб-мастеров и верстальщиков, — впоследствии став фундаментальной технологией и стандартом всего веба.
Go должен был стать заменой C++ в системном и ОС-программировании, а вместо этого стал популярным в серверной разработке и инфраструктуре, вытесняя скорее микросервисы на Java и C#, чем программы на C++.
Scala должна была быть лучшей версией Java — в итоге заняла нишу больших данных, где скоро, похоже, будет окончательно вытеснена Rust.
Kotlin должен был быть убийцей Java, а в итоге стал стандартом мобильной разработки под Android.
Dart должен был заменить JS и решить его фундаментальные проблемы: даже существовали экспериментальные сборки Chromium со встроенной Dart VM, но в официальный Chrome он так и не попал. Его хотели реанимировать с Angular 2, но победил TypeScript. Вторая жизнь началась в мобильной разработке на Flutter.
Ну, в общем, вы поняли: заниматься предсказанием и футуризмом в части языков программирования — неблагодарное занятие. История показывает, что пути языков предугадать сложно.
Правило as-if
Аарон Паттерсон круто парировал заявления DHH в своём закрывающем выступлении на том же Rails World 2026, пошутив, что готов начать продавать страховки от технического долга для тех, кто не будет читать код, который генерирует ИИ. Он встал в противоположный, тоже радикальный угол, заявив, что обожает использовать ИИ, чтобы кидать шлак-гранаты — да, те самые slop grenades, — как бы обесценивая этот инструмент в глазах разработчиков.
Мне не близка ни одна из радикальных позиций, я не хочу становиться в угол, мне нравится быть в середине. В этом плане мне откликается мысль Кента Бека из доклада Prodacity 2026: он сказал, что у него всегда были амбиции выше его технических навыков, а теперь ИИ даёт ему возможность делать то, что раньше было невероятно трудно, долго или дорого.
Когда я это услышал, то подумал: чёрт! Это же про меня.
Но Паттерсон при этом наносит крутой хук, который разбивает картинку выше про абстракции над машинным кодом: ИИ и естественный язык не могут сравниваться с ассемблером — компиляторы работают по правилу as-if. Правило «как если бы» — это про свободу компилятора менять код, но не результат. Переводчик с языка высокого уровня на машинный может переставить слова в предложении, вовсе убрать их или заменить синонимами, но он обязан сделать так, чтобы смысл остался тем же.
И это усиливает моё нытьё про детерминизм программ и его отсутствие у ИИ и естественного языка. Правило «как если бы» сохраняет детерминизм: оно требует, чтобы компилятор не вносил новую недетерминированность в поведение программы. Если программа была детерминированной, она должна остаться такой после всех оптимизаций.
Допустим, у нас есть код:
int a = 2 + 3;  // Компилятор может сразу заменить на 5
int b = 10;
print(a + b);   // Выведет 15
Компилятор может сделать так:
print(15); // Просто вывести 15, выбросив все переменныеДетерминизм: программа всегда выводит 15 — это её свойство.
Компилятор пообещал вам as-if, а ИИ такого обещания не давал: «для вашего английского правила as-if не существует». Естественный язык и ИИ-агенты не обладают такими характеристиками и не руководствуются таким правилом — а значит, к ним нельзя относиться как к ещё одной абстракции над машинным кодом.
Современные языки всё ещё нужны
Дело в том, что то, что хорошо в языке программирования и программном коде для человека, — то же самое хорошо и для ИИ-агента.
Behavior-Driven тесты позволяют чётко сформулировать границы и quality gates человеку. Типизация и линтинг — это ещё одни quality gates. Семантическая разметка и доступность делают вёрстку более качественной для интерпретации не только скринридером, но и ИИ-агентом.
Если в коде будут только переменные вида i или инструкции INT и JMP с названиями регистров вроде EAX, то насколько тяжело ИИ-агенту будет собрать доменный и бизнес-контекст? Придётся читать чуть ли не всю кодовую базу для выполнения и валидации даже очень простого изменения в коде, не говоря уже о добавлении новой функции.
На самом деле вездесущий язык (ubiquitous language) из Domain-Driven Design, на мой взгляд, как раз критически важен для верного выстраивания подходов по работе с ИИ, постановки задач в определённой предметной области и организации кода. В целом Domain-Driven Design в эпоху ИИ становится одной из наиважнейших дисциплин, на мой взгляд, и это заслуживает отдельного эссе.
Когда-то давно я любил говорить, что при ревью и оценке кода надо руководствоваться правилом TUBED — testable, understandable, browseable, extendable, documented. Вездесущий язык помогает как раз с understandable и browseable — ориентироваться в коде и быстро находить нужные участки для изменения. Это напрямую связано с экономикой использования ИИ-моделей и токенов.
Код читать всё ещё нужно
Интересен и другой аспект. Обсуждая всё это, мы, кажется, забываем о чудовищной монополии на LLM-инструменты. Я говорю именно про топовые серьёзные инструменты для инженеров. Ни одна локальная модель, обученная внутри корпорации, не способна сравниться с инструментами Anthropic, OpenAI, Z.ai, Kimi, xAI и Gemini.
Ответ очень простой: это концентрация и обладание ресурсами, а именно дата-центры, доступ к электричеству и количеству вычислительных мощностей — GPU. И именно поэтому тут представители только двух крупных экономик — США и Китая. Никто другой не может предоставить сопоставимые инструменты, и с этим приходится мириться даже очень большим и богатым корпорациям: они сливают свой код на сервера этих компаний, чтобы работать с их передовыми кодинговыми моделями.
Когда мы привязываемся к облачным провайдерам вроде AWS или Cloudflare — да, это тоже зависимость от гиганта, но наше решение переносимо, всегда можно развернуть ПО на своих мощностях, заменить платные решения на open-source self-hosted или написать свои. Это, кстати, отлично видно в РФ в условиях западных санкций, крупные игроки начали делать свою инфраструктуру, где-то допиливать что было, где-то делать что-то свое. Можно назвать это цифровой независимостью. Вместо AWS — MWS, вместо Cloudflare — Яндекс. Китай был таким уже давно.
По некоторым оценкам, более 70% мировых мощностей для ИИ принадлежит пяти американским гиперскейлерам — Amazon, Google, Meta, Microsoft и Oracle. Около 5% — у китайских компаний, остальное размазано и не сосредоточено в одном месте.
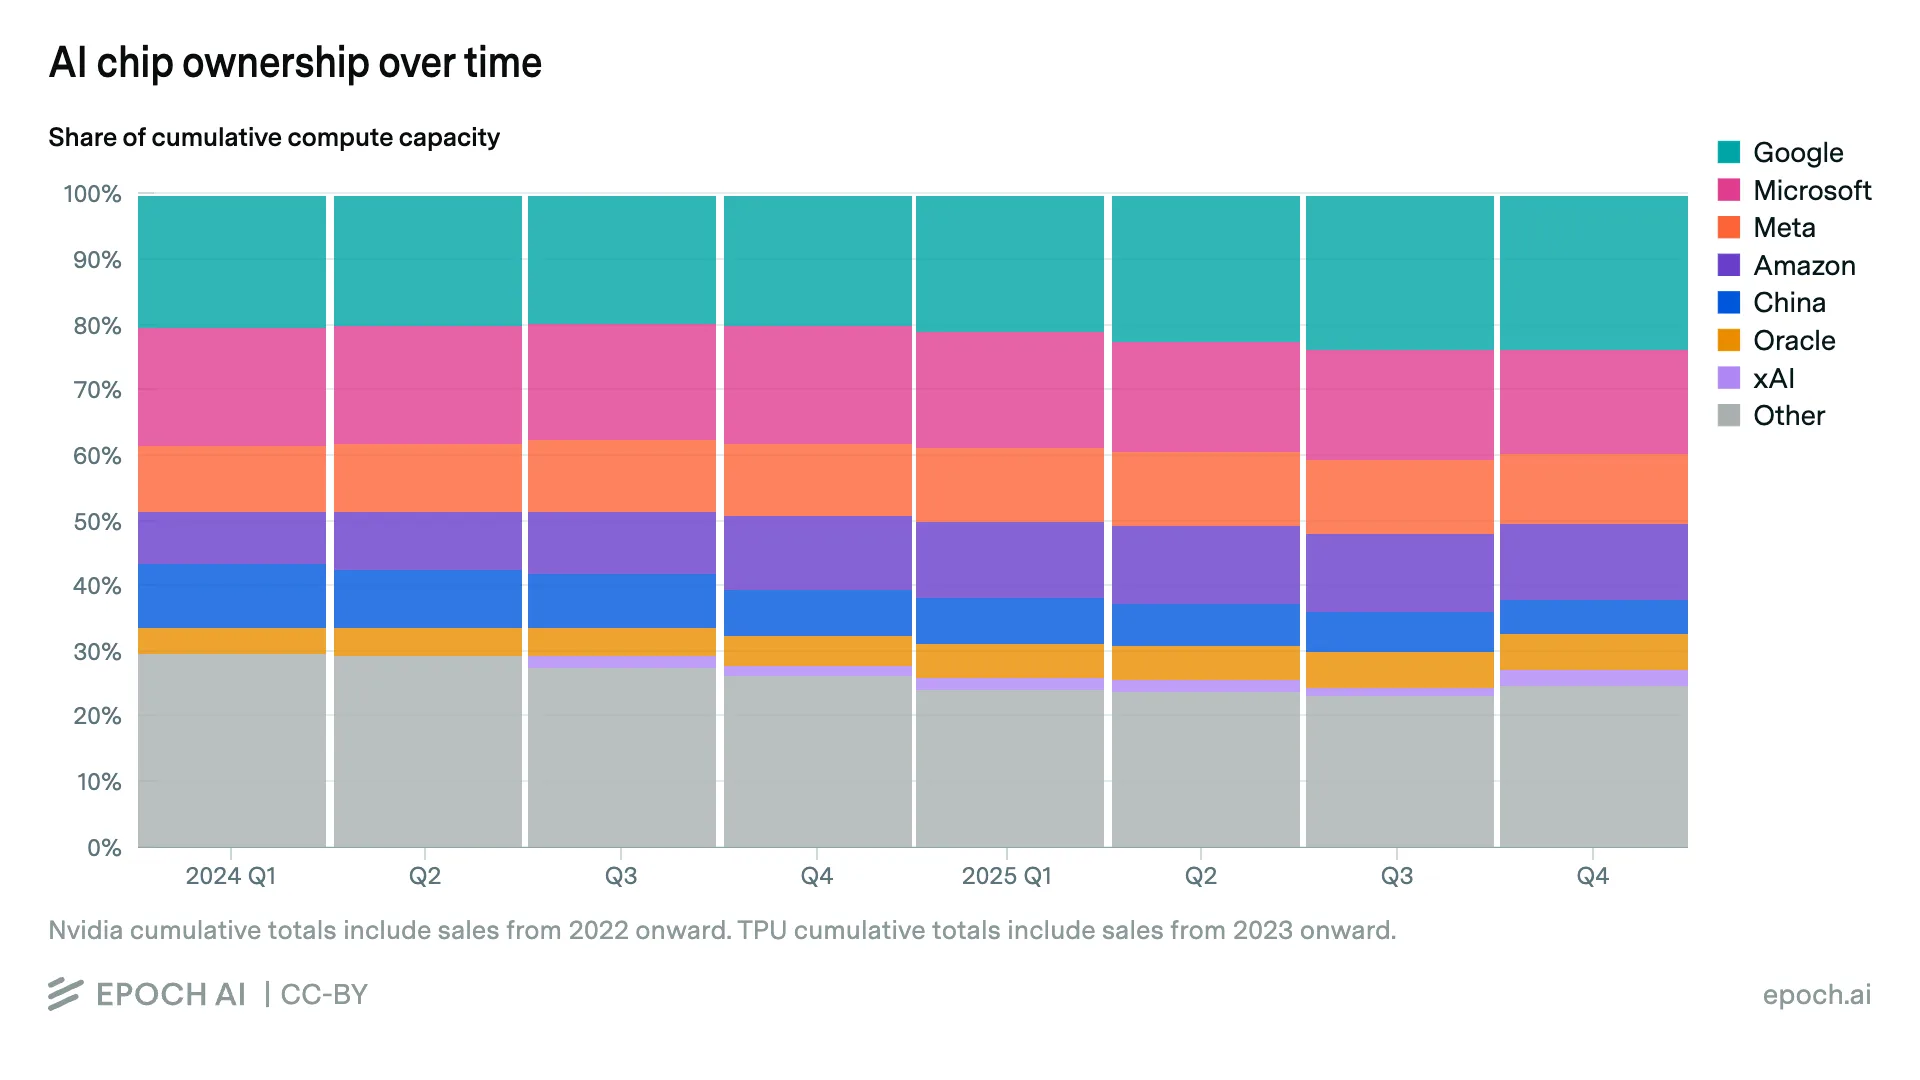
Учитывая такую беспрецедентную монополию на инструменты, умение писать, читать и разбираться в коде всё ещё критично — как минимум с точки зрения безопасности.
Крайне показательный эксперимент получился, когда китайскую модель Qwen3 Coder попросили написать код для американской оборонной инфраструктуры: на том же тесте такие приложения оказались взламываемыми заметно чаще — 70% против 59%, когда заказчиком была китайская сторона. И это то, почему код читать нужно.
Экономически полностью переходить на модели тоже может быть невыгодно для определённых бизнесов. Gartner посчитал, что если фиксированная подписка будет заменена оплатой количества использованных токенов, то счета за LLM превысят среднюю зарплату инженеров к 2028 году. Вице-президент Nvidia Брайан Катандзаро признал, что в некоторых командах расходы на вычисления для ИИ уже «значительно превышают» затраты на персонал. А технический директор Uber исчерпал годовой бюджет на ИИ ещё в начале 2026 года, в основном из-за оплаты токенов для инструментов вроде Claude Code.
Кент Бек в своём докладе на Prodacity 2026 сказал:
«Если бы мне пришлось выбирать между системой, которую могут прочитать люди, и системой, которую не могут, — я бы выбрал ту, которую могут.»
И я, как и многие инженеры, тут полностью солидарен.
Умение читать код — важнейший, незаменимый навык для программистов: профессионалы тратят значительно больше времени именно на чтение и понимание существующего кода, чем на написание нового. Хотя инструменты ИИ и автоматизированное тестирование могут заниматься проверкой, они не могут заменить человеческую оценку качества кода, архитектуры и его замысла.
Современный инженер должен быть оркестратором и умелым администратором ИИ-агентов. Нужно уметь запускать и настраивать циклы ИИ, но соотношение «читать / не читать» должно быть 20/80 по принципу Парето или 30/70, как описал в своём твите Тим Суини — глава Epic Games, создатель игрового движка Unreal Engine: критические участки системы всё ещё на человеке, а вся остальная шаблонная обвязка может быть отдана агентам.
Человеческое суждение сдвигается, чтобы циклы оптимально работали, но определённо не исчезает насовсем.
Мне откликается такой прагматичный подход, именно так примерно сейчас я сам и работаю. Где-то между третьим и четвёртым подходом, с принципом доверия 20 на 80. Я отпускаю руль и жму на газ, когда делаю учебные проекты или игрушки с детьми, и хватаюсь за руль и притормаживаю, когда у пользователей на проде появляются «белые вкладки».