«Конец программирования» — так обозвал свою статью в блоге Пол Дикс, создатель InfluxDB. Поводом стала новость о том, что Bun переписали с Zig на Rust: один разработчик с пререлизной моделью Claude Fable и армией агентов (на пике около 64) за 11 дней прогнал механический порт с одного языка на другой. Исходник — 500k строк Zig без комментариев; в merge ушёл diff порядка +1 миллиона строк. Масштаб поражает.
Bun — это среда выполнения и тулкит для JavaScript/TypeScript, современная альтернатива Node.js и Deno. В декабре 2025 Anthropic купил Bun — в том числе как инфраструктуру вокруг своего Claude Code; проект остаётся open source.
Подобная миграция раньше заняла бы множество человеко-часов и команду инженеров, хорошо разбирающихся в системном программировании на достаточно нишевых Zig и Rust (ну, согласитесь, это вам не Java и JavaScript).
Но «конец программирования» — ложный вывод из демо и громких миграций. Мертва роль кодера-переводчика: человека, который прочитал документацию и напечатал на клавиатуре код как перевод требований в язык, понятный машине.
Эту модель ИИ автоматизировал. Она мертва. Не мертва инженерия. Скорость генерации — ещё не готовность системы.
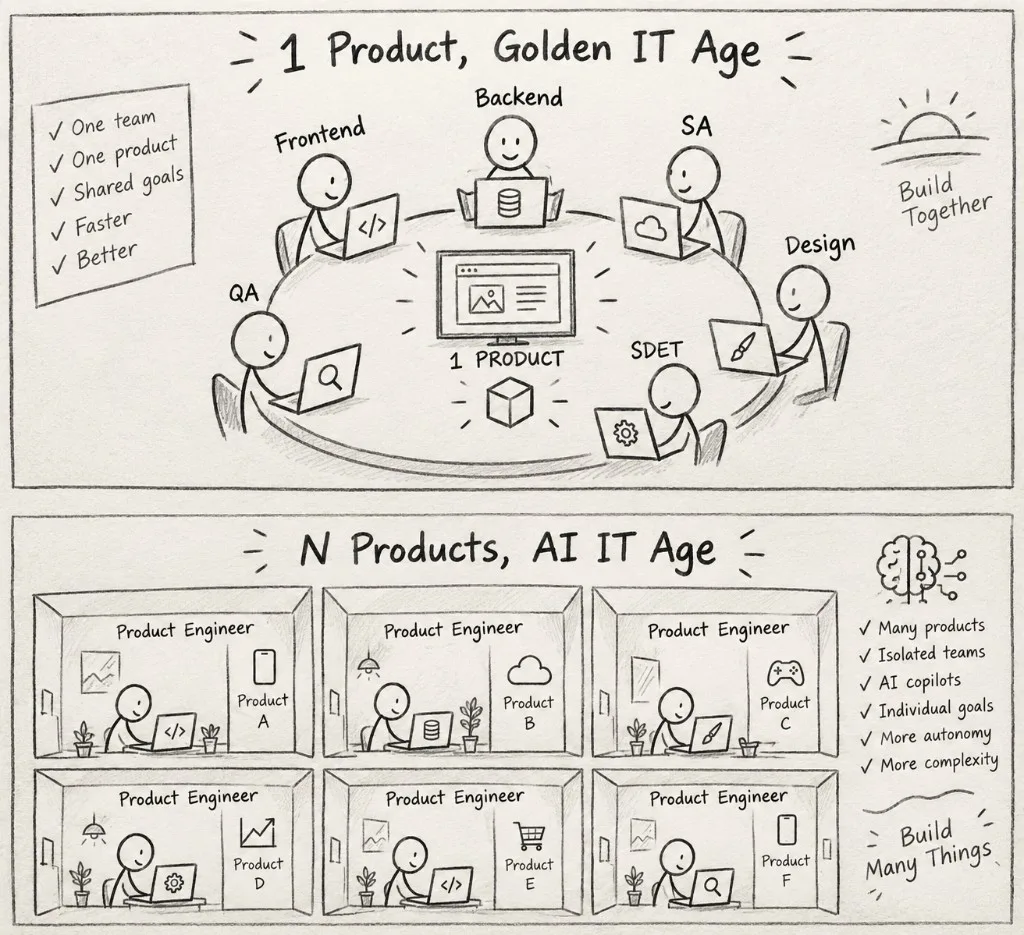
Вайб и нейрослоп
Инженеры больше не нужны, и с лучшей подпиской на последнюю модель можно сделать всё что угодно
Люди с GPT Astra показывают невероятные 3D-демо-игры, агенты клепают клоны привычных редакторов и досок, а Miro на фоне этого уходит к Bending Spoons всего за $1 млрд — холдинг, который скупает умирающие стартапы. А когда-то ее стоимость оценивали в 20 млрд и пророчили будущее Figma, но LLM с легкостью генерит свои собственные решения по типу досок или замен трекеров, вроде Jira. Зачем тогда покупать?
Смотря на это безобразие, легко сделать ошибочный вывод: инженеры больше не нужны, и с лучшей подпиской на последнюю модель можно сделать всё что угодно.
На деле всё это может вылиться в мусорный и багоопасный нейрослоп. Задача переписать решение с одного языка на другой не выглядит как проектирование с нуля — и в этом главный нюанс. У Bun был оракул: тот же test suite, те самые quality gates. Это мерило успеха или провала работы LLM. Сейчас модное слово для обвязки вокруг агента — harness: всё, что мы строим, чтобы он выдал ожидаемый результат. Без quality gates миллион строк кода — это не подвиг, а риск.
ИИ-агент генерирует много кода и лучше ориентируется в огромном контексте — в этом он превосходит типичного «кодера». Вопрос цены токенов и электричества остаётся, но он вторичен рядом с вопросом: как проверить, что сгенерированное вообще то, что нужно.
Недетерминизм
ИИ же стремится к оверинжинирингу как к точке «совершенства» и перфекционизма
Самая главная проблема моделей — они недетерминированы. Когда мы раньше писали код, мы были уверены: вот этот алгоритм из миллиона прогонов даст один и тот же результат — определённый input даёт определённый output. Так работает математика, так работает физика, так работала информатика. ИИ выдаёт различный результат на одни и те же входные данные. С этим инженеры раньше почти не сталкивались: непредсказуемым в разработке ПО был человек, не машина.
Компьютерная инженерная система должна быть детерминированной, предсказуемой, точной. Как добиться этого с ИИ? Ответ скучный и старый как мир: тесты.
В инженерных кругах любят придумывать новые слова, но очень часто это упаковка старых практик. AI Evals как часть harness — это просто quality gates: те же проверки кода и логики, которые инженеры годами настраивали до этого.
У меня есть старая статья, где я конспектировал различные виды автоматизированных тестов и упоминал о TST — Total System Testing, тотальное покрытие системы тестами. Тогда я говорил, что это сказка, к которой лучше не стремиться: такие наборы тяжело поддерживать. Прагматичнее баланс — пирамида или трофей тестирования, покрытие где-то около 80%.
Сейчас всё немного изменилось: тесты тоже генерит агент, писать и чинить их стало дешевле. Если тест поломался — перегенерили. Кажется, что можно стремиться и к полному покрытию: модульные, интеграционные, системные. Плюс простой — имея такие gates, мы меньше боимся недетерминированности агентов. Оговорка конечно остаётся: дешёвые тесты это не значит полезные. Мусорный сгенерированный suite тоже нейрослоп, только с другой стороны.
Ещё один ложный успокаивающий жест — ревью (/multi-model-review в Cursor или subagent_type: general-purpose в ZCode): пусть одна модель (или субагент) ревьюит результат другой. Это не заменяет quality gates. Там тот же недетерминизм: модель проверяет модель, и на выходе снова вероятностный текст, а не формальная проверка.
Циклы вроде Ralph loop, в которые так уходит кодогенерация, иногда просто неоправданны: агенты, как машины, пытаются перебрать все сценарии и проблемные кейсы — даже когда это не нужно. Нет механизма компромисса.
Эту роль раньше выполнял человек: он брал на себя ответственность за угловатости системы и её несовершенство. ИИ же стремится к оверинжинирингу как к точке «совершенства» и перфекционизма — и без внешней рамки может крутиться в этом цикле бесконечно.
Оракул - путь к детерминизму?
А ответственность — определённо на человеке. ИИ-агента никто не будет винить в том, что прод упал: он же машина.
Есть ещё одно модное слово — это «оракул». Говорят именно в этом кроется успех работы LLM. Но и тут тоже надо развеять туман определения, оракул — это что-то вроде главного агента, умного арбитра, который держит контекст всей задачи и направляет, ревьювает и калибрует работу быстрых агентов исполнителей. Они могут к нему обращаться за советом, это прагматичное разделение работы моделей. Оракул — мощная дорогая умная модель, исполнители — мелкие и быстрые flash-модели. Но эта связка все еще алхимия. Видимо, это какая-то отсылка к древней греции: жрецы, оракулы, провидцы...
Для меня настоящий оракул это исполняемая проверка, которая без участия модели отвечает «да/нет» на конкретное ожидание. Спека в markdown — это постановка, все та же алхимия. Оракул — то, что проверяет постановку. Если проверка не умеет кричать красным цветом — это не оракул, это пожелания и инструкции.
Мини-пример. Нужен логин. В чате агенту можно написать что угодно. Markdown-спека: «после верного пароля пользователь попадает в кабинет». Это все ещё алхимия. Оракул же — это тест вроде:
it('sets session cookie on valid credentials', async () => {
  const res = await login('user@example.com', 'correct-password');
  expect(res.status).toBe(200);
  expect(res.headers['set-cookie']).toMatch(/session=/);
});
Агент может переписать хендлер на Express, Hapi, Hono, NestJS или свой роутер. Ему можно скормить другую модель, субагента, Ralph loop. Пока этот тест красный — успеха нет. Пока зелёный — поведение по этому контракту есть, даже если дифф выглядит инопланетно. Вот где живёт контекст успеха: не в истории чата, а в файле, который CI гоняет снова и снова.
У Bun «оракул» был жёстким и уже существовал к моменту миграции: тот же suite на совместимость с Node и на поведение рантайма. В посте про Rust-порт пишут прямо: механический порт при минимальных изменениях поведения, тот же test suite. Агенты писали .rs сколько угодно — мерило не «субагент Fable сказал ок», а «все тесты прошли».
Без этого миллион строк — это риск и лотерея.
Отсюда правило: сначала контракт, который умеет падать, потом генерация под него. Markdown /plan и OpenSpec полезны, чтобы сформулировать ожидание и не потерять его между сессиями. Но пока из спеки не вырос хотя бы один падающий тест, инвариант типов или сканер с exit code — у вас постановка задачи, а не оракул.
Инструменты вторичны: они воплощают куски оракула. Жёсткое ядро — то, что детерминированно бьёт по логике: мои нелюбимые типы (tsc), unit/integration (Vitest/Jest). Вокруг — гигиена (ESLint/Oxlint, Prettier/Oxfmt), пока люди все ещё ходят читать код это нужно. E2e (Playwright) и Lighthouse — полезны, но часто шумные; нужно следовать по пирамиде тестирования или трофею, без фанатизма. Для массовых продуктов — проверка доступности с axe.
Для цепочки поставок — ясный контекст риска, тоже в виде проверок, а не абзаца в AGENTS.md: Semgrep по коду, Trivy и npm audit по зависимостям, Gitleaks по секретам, Syft как SBOM (inventory артефакта под CVE). CDN CSP/HSTS headers — оракул на краю рантайма. Имена можно менять, но инженерный подход один: зафиксировать ожидание так, чтобы машина могла сказать «нет».
Именно такой набор сужает класс ошибок и делает приёмку бинарной: агент может галлюцинировать, но часть мусора отсечётся, пока линт, типы, тесты и сканеры не дадут exit code 0. Это практический harness — не markdown-заклинание, не оракул истины, а пайплайн.
Но есть ловушка. Full access для агента — опасная игрушка дьявола. Он без проблем залезет в каждый gate и отредактирует его: ослабит правило ESLint, выкинет «мешающий» тест, расширит allowlist, снимет порог Lighthouse. ignore и allowlist сами по себе чаще ослабляют проверки — ими агент как раз любит раздувать дыры. Нужна защита конфигов gates: CODEOWNERS / branch protection на CI, ESLint, пороги Lighthouse, lockfile и запрет агенту писать в эти файлы без человеческого ревью.
Пример простой. Агент без проблем поднимет версию пакета, если «так надо для сборки». Но вряд ли по умолчанию пойдёт смотреть CVE (npm audit / Trivy) и совместимость с платформами ваших пользователей. Варианта два: либо дать этот контекст в плане / спеке заранее, либо выстроить сильные gates, которые без разрешения того, кто берёт на себя ответственность, не пустят изменение дальше. А ответственность — определённо на человеке. ИИ-агента никто не будет винить в том, что прод упал: он же машина.
Сначала спека
Если системы ещё нет, а мы хотим её разработать с помощью ИИ, не умея программировать, сначала нужно описать ожидания. Желательно — в виде тестов, которые потом проверят результат работы агента.
Тут всплывает подход, который описал Кент Бек, — Test-Driven Development. Сколько лет мусолят эту тему? И как будто в природе этот зверь не встречается: в 90% команд тесты пишут постфактум. Я сам когда-то был поборником TDD, пиарил его — и потом забил: против течения тяжело плыть. При этом Бек подход не придумал: нашёл в инженерной книге отца. В зачатках XP это называлось Test-First — сначала тест, потом реализация. Это очень старая техника, и в ней есть невероятный прагматизм, который сейчас заиграл новыми красками.
Всё это трансформировалось потом в Behavior-Driven Development: сначала формулируем поведение системы, из него — тесты, потом код. Мне кажется, BDD — фактический эквивалент того, что сейчас пиарят как Spec-Driven Development. Просто слова поменяли. Specification-Driven — тот же уход в DSL, описывающий поведение. Нам нужна сначала спека.
Появляются даже фреймворки, как описывать спеки — например OpenSpec. Забавно: раньше были фреймворки на языках программирования, на фронте и бэке. Теперь — фреймворки, чтобы правильно описать markdown: глобальная спека, локальная, ещё какая-то. Смешно, не смешно — но это реальность. И в этом есть прагматизм: описать в балансе — не слишком подробно и не слишком на верхнем уровне — то, что хотим получить. На основе спецификации ИИ генерит код. В самом простом варианте это скилл /plan, который предшествует реализации и сохраняет контекст постановки. Поэтому опытные инженеры знают: ставить задачу агенту надо со спеки.
Инженерия - это процесс от проектирования, дизайна и планирования до реализации, отладки и тестирования.
Реализация и отладку, то что посередине, теперь на себя забирает ИИ. Проектирование и планирование фундаментальные фазы — это все еще на инженере-программисте.
Чтобы проверить работу, нужны точные тесты — желательно до того, как что-то уйдёт в продуктив. Желательно, чтобы они описывали то поведение, которое мы хотим от системы. Старые практики — модульные, интеграционные, e2e, BDD, TDD — остаются актуальны даже в эпоху кода, который уже не пишут люди.
Вот тут должна появиться реклама инфоцыгана, который продаёт курсы по вайбкодингу. Раньше такие люди учили JavaScript и React — хоть какой-то уровень инженерии всё же требовался. Теперь будут учить правильно писать markdown-спеки на русском или английском. Лучшее обучение по-прежнему одно: брать и делать. Книжки по React и раньше выглядели кринжево; книжки «как правильно вайбкодить markdown» будут апофеозом кринжатины в инженерии.
AGENTS.md - Нам нужна химия, а не алхимия
Всё, что касается обвязки из правил на естественном языке, — чистой воды алхимия, подкреплённая в лучшем случае индивидуальными субъективными выводами. Люди всё так же ищут серебряную пулю — только теперь в markdown-файлах, а не в шаблонах проектирования и алгоритмах на формальном языке. Правда в том, что нет и не будет универсального текста для AGENTS.md. Даже попытки слепить универсальные промпты и скиллы вроде ponytail «на все проекты» — провальная идея.
Нужно формировать правила под каждый конкретный проект. AGENTS.md должен быть сбалансированным: не огромным и не пустым, только базовая, но специфичная проекту информация. Всё остальное уходит в rules — правила, к которым агент подчиняется при определённой работе. Модели учились на открытых источниках, и в некоторых областях они слабы или просто упускают важное, если явно не указать. Безопасность, доступность — половина интернета имеет проблемы с accessibility, модель училась на этих примерах, поэтому явные правила в этой категории обязательны.
Хороший ориентир описала команда OpenAI в Harness Engineering: идея в прогрессивном раскрытии контекста (progressive disclosure). Нельзя вываливать на агента сразу «талмуд» правил — контекст засоряется, фокус размывается, а файл моментально протухает. Вместо этого репозиторий превращается в структурированную базу знаний с чёткой иерархией. Практическая адаптация этой схемы под систему правил выглядит так:
AGENTS.md           # Базовое описание, оглавление и карта репозитория (~100 строк)
ARCHITECTURE.md     # Архитектура, границы слоёв и доменов
plans/              # Подход OpenSpec, но мало пользы для соло-работы; нужно только при параллельных агентах
rules/
├── DESIGN.md          # Дизайн-система, токены и связка с Figma
├── FRONTEND.md        # Фронтенд-стек, конвенции и правила компонентов
├── ACCESSIBILITY.md   # Явные требования доступности (a11y)
├── PLANS.md           # Подход к декомпозиции и составлению плана (/plan)
├── PRODUCT.md         # Бизнес-контекст продукта и пользовательские сценарии
├── QUALITY_GATES.md   # Тесты, типы, линтеры и форматтеры
├── RELIABILITY.md     # Оракул надёжности, инварианты и мониторинг
└── SECURITY.md        # Ограничения безопасности, санитизация и OWASP-чеклисты
Без явно заданной в правилах и спецификации архитектуры непонятно, как агент пойдёт строить приложение: какие библиотеки выберет, писать своё или переиспользовать, как разделить доменные модели (Domain-Driven Design). Даже простое: Tailwind или SCSS Modules? Это техническая информация, которую человек без понимания технологий не сформулирует.
Сгенерировать простой сайт-визитку в сдержанном дизайне с приятным интерфейсом — это одна задача, разрабатывать сложную веб-систему с сотнями отдельных экранов на консистентной дизайн системе — это другая задача. Нужна формализация дизайн системы, порядок в Figma, MCP-коммуникация к трекеру, где описания задач и к Figma, где есть макеты. Формализация стэка и библиотек, а также screenshot-тесты.
Можно ли не формулировать? Пускай ИИ сам решит. ИИ ничего не решает — он делает по образу и подобию того, что превалирует в весах его знаний. Велик риск быстро прийти к энтропии, где система превратится в один большой и неповоротливый нейрослоп.
Подобно тому, как вечная борьба с энтропией приводила разработчика к необратимой встрече с рефакторингом, необратима и постоянная переработка правил агента и текста в rules и AGENTS.md. Harness нельзя упаковать в фреймворк по типу React и переиспользовать «как есть».
Конфигурация «стареет»: модели и инструменты улучшаются, а инструкции остаются. Накопление правил раздувает файлы, повышает расход токенов и снижает качество работы агента. Нужно периодически проверять качество, безопасность и актуальность конфигурации, оставляя только то, что действительно приносит пользу. В этом плане постоянная работа с markdown-файлами скиллов и правил на естественном языке мало чем отличается от практик рефакторинга и дизайна в формальных языках.
Это, кстати, одна из услуг будущего: раньше нанимали сервисную компанию, чтобы трансформировать легаси; по тому же принципу будут нанимать инженеров, чтобы привести в порядок нейрослоп, который на коленке склепали непрограммисты в желании сэкономить на инженерах.
Ответ - ограничения
Чтобы как-то подытожить написанный выше сумбур: вам нужно немного внимания и ограничения (constraints).
Ограничения и инварианты — это то, на чём должны фокусироваться инженеры современности и будущего. А выстраивается это через чёткие и однозначные правила для ИИ-агента, quality gates и допустимые пороги бюджета вычислительных и экономических ресурсов. Только пройдя все эти проверки, решение может попасть в боевое окружение — к людям.
Агент может предложить и реализовать для вас что угодно. Но только ваши ограничения определяют, достаточно ли безопасны, корректны, масштабируемы и полезны предложение и реализация ИИ, чтобы вы и ваша команда могли отдать это миру.
Схема из статьи Эдди Османи "Agentic Code Quality":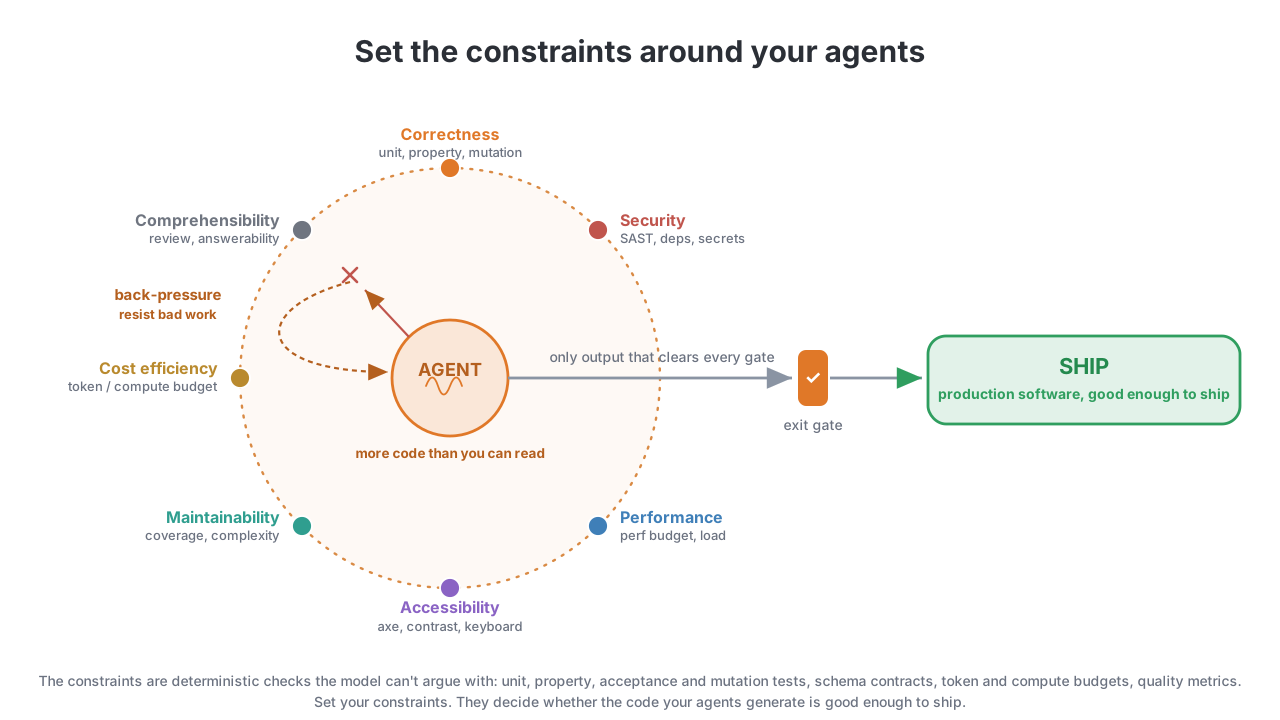
Что выживает
Принципы вроде SOLID, YAGNI, KISS, DRY, ETC по-прежнему помогают формулировать верные ожидания — и от системы, и от обвязки, которая её разрабатывает.
Нужно ли учить конкретный язык? Наверное, нет: языки годами эволюционировали ближе к DSL, чтобы быть читаемыми для человека, оставаясь формальными. Сейчас они могут быть нечитаемыми, но оптимальными — LLM переведёт. Как переводит русский на английский и обратно.
Но архитектурное и инженерное мышление, принципы, подходы в дизайне — это всё будет нужно. Нужны высококвалифицированные архитекторы и оркестраторы систем: те, кто может правильно задать вопрос, сформулировать мысли и ожидание. Исполнители, не умеющие думать, нужны в меньшей степени.
Вернёмся к Bun. Миллион строк за одиннадцать дней — не доказательство, что программирование кончилось. Это доказательство того, что при жёстком harness и quality gates недетерминированный агент может выдать рабочий результат. Без рамки тот же масштаб — просто очень быстрый путь к нейрослопу.